نتیجهها
این عددها را درست بخوانید
همهٔ عددهای این صفحه روی پیکرهٔ کوچک و ساختگی خود مخزن به دست آمدهاند: ۲۵ سند فارسی که برای همین دوره نوشته شده، ۵۹ پرسش پاسخدار (qa.jsonl) و ۴۶ بازنویسیِ پاسخدار (qa_paraphrase.jsonl)، با مدلهای آفلاین و قطعی: HashingEmbedding، یک FakeLLM استخراجی و یک LLM قاعدهمحور برای عامل. این عددها نشان میدهند چطور باید اندازه گرفت و هر انتخاب عدد را به کدام سمت میبرد، نه اینکه یک مدل عصبی واقعی چه نمرهای میگیرد. با این حجم، یک پرسش حدود ۱٫۷ واحد درصد جابهجا میکند؛ بازههای اطمینان را در درس ۱۰ ببینید.
مدلهای برداری واقعی را با دفترچهٔ Colab (GPU رایگان، هر دو مجموعه پرسش) یا examples/benchmark_embeddings.py روی کامپیوتر خودتان بسنجید و سطرهای اندازهگیریشده را به جدول «نتیجههای مدلهای واقعی» در درس ۰۵ اضافه کنید.

همهٔ نمودارها با یک اسکریپت از نو ساخته میشوند و عددهای پشتشان در docs/eval/readme_numbers.json ذخیره میشود:
نرمالسازی (درس ۰۲)
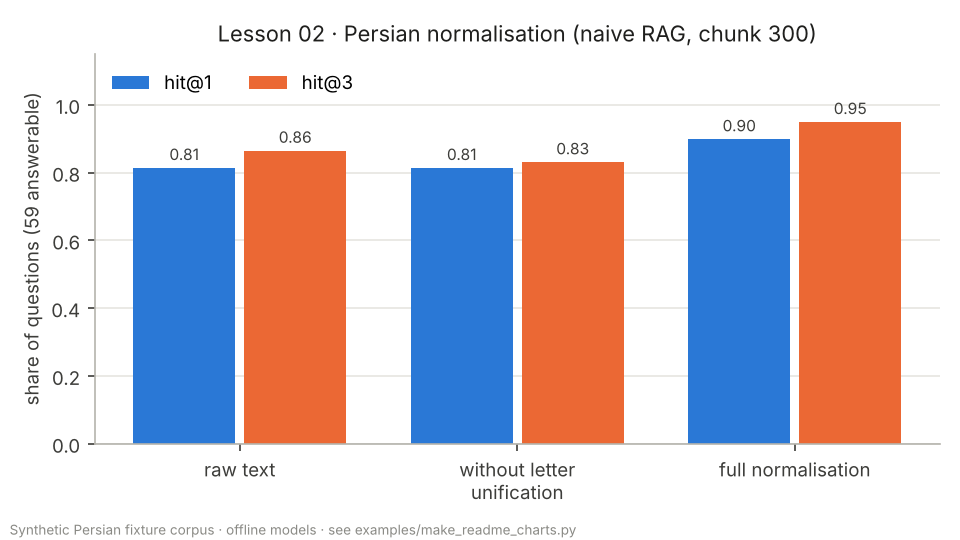
پایپلاین سادهٔ درس ۰۱ با قطعههای ۳۰۰ نویسهای: نرمالسازی hit@1 را از ۰٫۸۱ به ۰٫۹۰ و hit@3 را از ۰٫۸۶ به ۰٫۹۵ میرساند. با خاموش کردن فقط یکسانسازی حروف عربی و فارسی، hit@1 دوباره ۰٫۸۱ میشود؛ گامهای دیگر روی این پیکره اثر قابلاندازهگیری ندارند. درس ۰۲
تعمیر متن PDF (درس ۰۳)
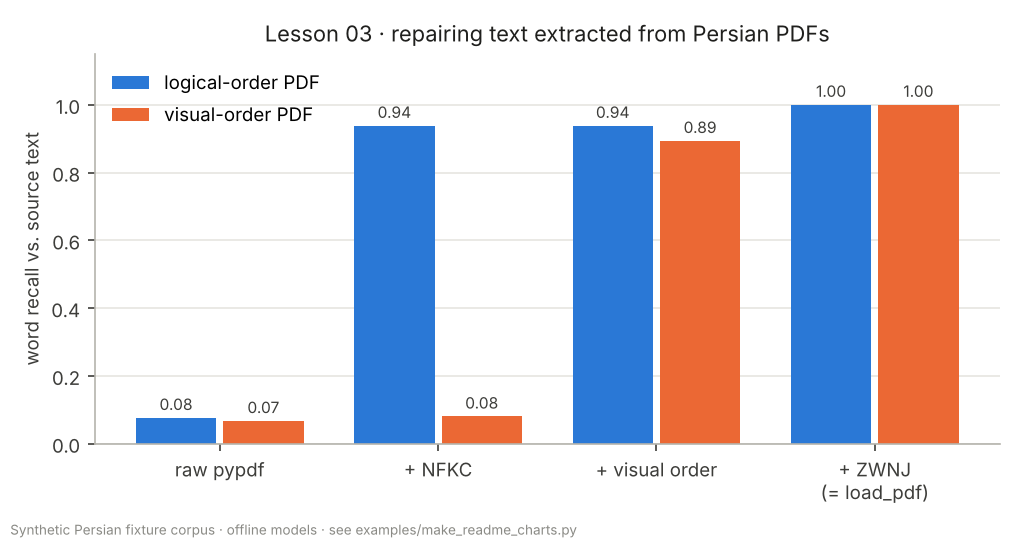
NFKC بیشتر متن PDF با ترتیب منطقی را برمیگرداند (۰٫۰۷ ← ۰٫۹۴) ولی برای PDF با ترتیب دیداری تقریباً بیاثر است (۰٫۰۸). اصلاح ترتیب و بازیابی نیمفاصله از روی شکل حروف هر دو را به ۱٫۰۰ میرساند. PDFهای نمونه با شکلدهندهٔ خود دوره ساخته شدهاند؛ PDF واقعی شلوغتر است. درس ۰۳
قطعهبندی (درس ۰۴)
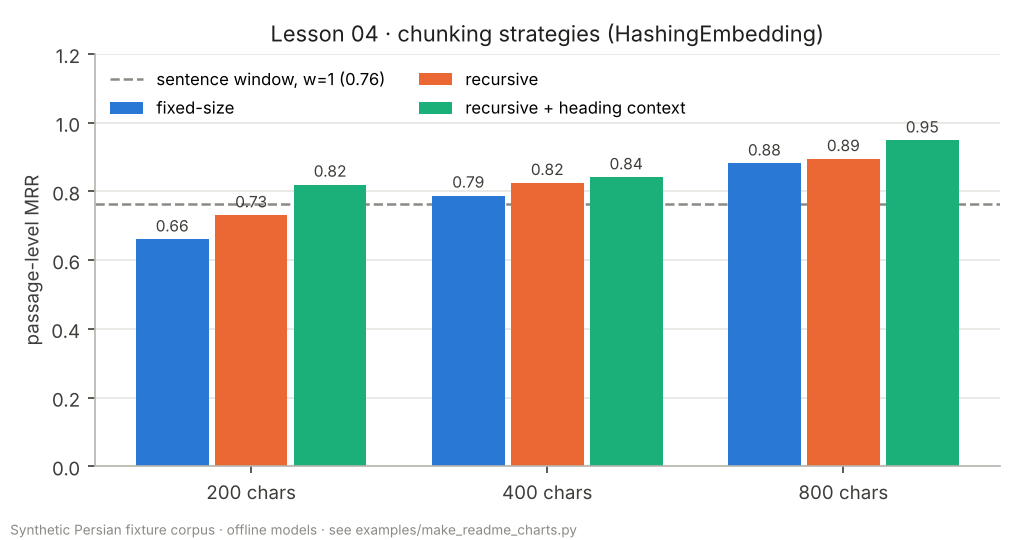
در هر اندازه، قطعهبندی بازگشتی با سرتیتر بهترین است؛ سرتیتر ارزانترین بهبود است (پنجرهٔ ثابت ۲۰۰: MRR ۰٫۶۶ ← بازگشتی با سرتیتر ۲۰۰: ۰٫۸۲). پیشفرض دوره بازگشتی ۴۰۰ با سرتیتر است (۰٫۸۴). درس ۰۴
جستوجوی ترکیبی (درس ۰۷)
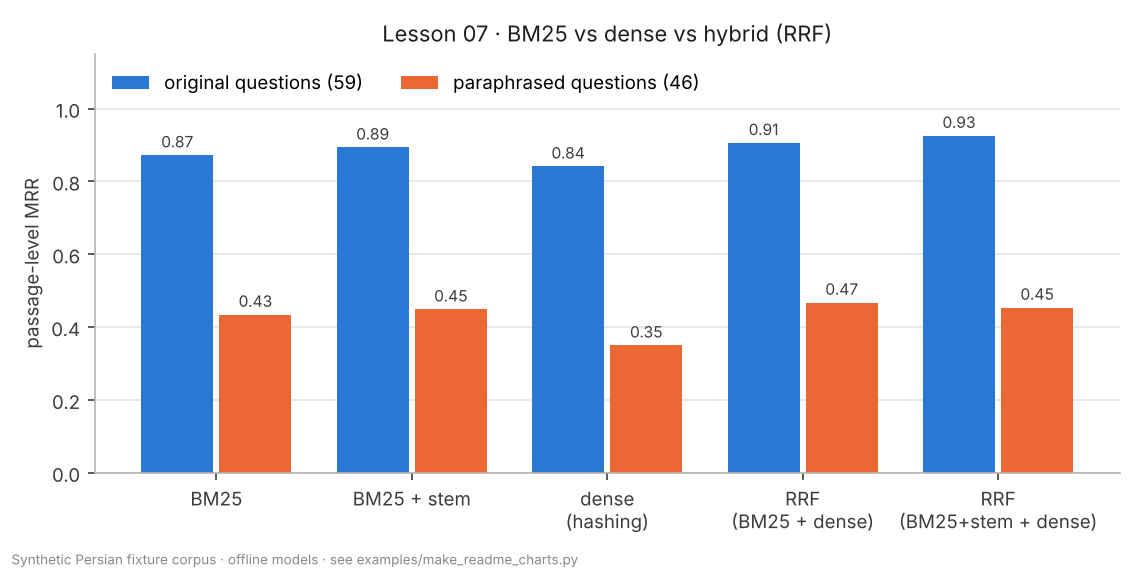
روی پرسشهای اصلی، RRF روی BM25 (با ریشهیابی سبک) و برداری بهترین MRR را در میان روشهای بدون تنظیم دارد (۰٫۹۳؛ ترکیب وزنی ۰٫۵/۰٫۵ با اختلافی در حد نویز جلوتر است). بازنویسیها همهٔ روشهای واژگانی را نصف میکنند و HashingEmbedding — که زیر پوستش واژگانی است — بدترین است (۰٫۳۵). بوتاسترپ جفتی درس ۱۰ فقط «ترکیبی بهتر از برداری تنها» را قابلدفاع میداند. درس ۰۷
بازرتبهبندی (درس ۰۸)
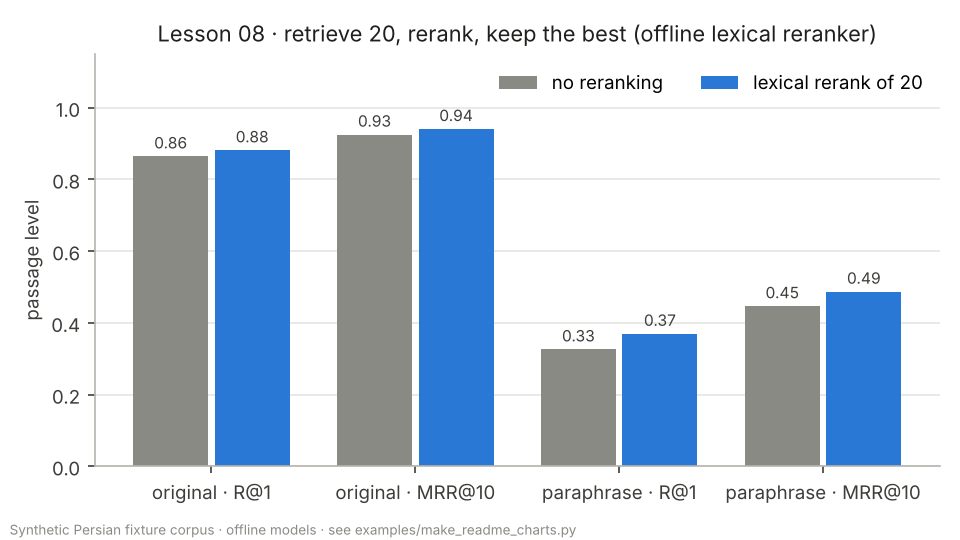
بازرتبهساز واژگانی آفلاین روی ۲۰ نامزد: R@1 از ۰٫۸۶ به ۰٫۸۸ (اصلی) و از ۰٫۳۳ به ۰٫۳۷ (بازنویسی). بازهٔ اطمینان این بهبود صفر را در بر دارد؛ بازرتبهساز متقاطع واقعی را با examples/reranking.py --cross-encoder بسنجید. درس ۰۸
عامل در برابر پایپلاین (درس ۱۱)
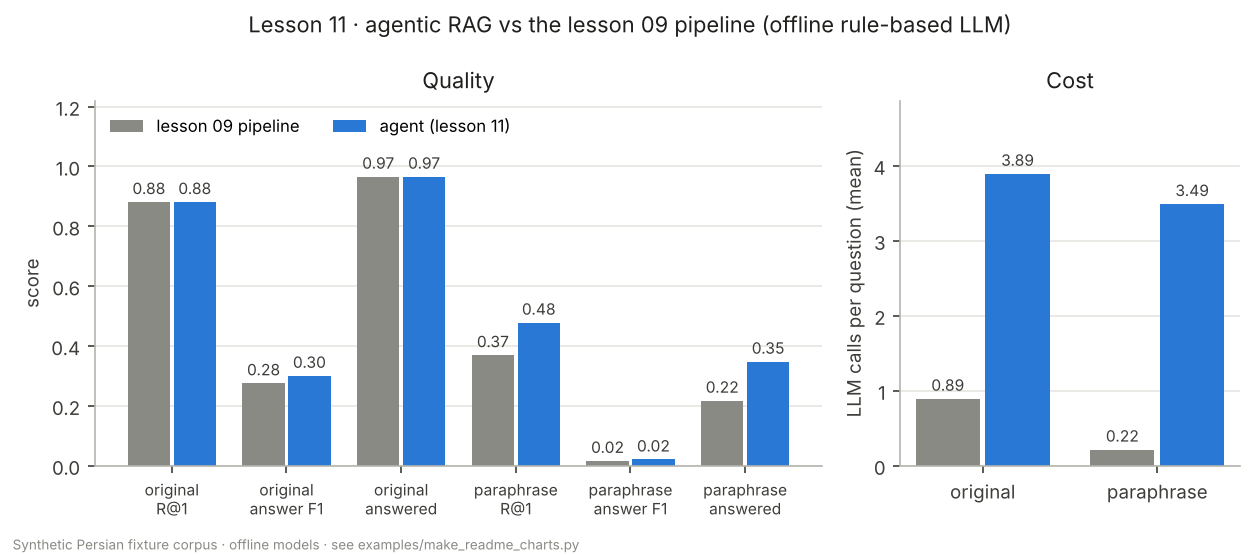
روی پرسشهای اصلی، عامل همان بازیابی را دارد و F1 پاسخ را ۰٫۰۲۵ بالا میبرد (بازهٔ اطمینان به صفر میرسد)، با ۳٫۸۹ فراخوانی LLM در برابر ۰٫۸۹. روی بازنویسیها R@1 از ۰٫۳۷ به ۰٫۴۸ و نرخ پاسخ از ۰٫۲۲ به ۰٫۳۵ میرسد — و همهٔ این بهبود از قاعدههای محاورهای میآید. درس ۱۱
پایپلاین کامل و دروازهٔ CI (درس ۱۰)
پایپلاین دوره در هر PR با خط پایهٔ docs/eval/baseline.json مقایسه میشود و اگر معیاری بیش از ۰٫۰۲ افت کند، CI شکست میخورد. گزارش کامل با بازههای اطمینان: گزارش ارزیابی پایپلاین.
| معیار | اصلی | بازنویسی |
|---|---|---|
| بازیابی R@1 [بازهٔ ۹۵٪] | 0.881 [0.797, 0.949] | 0.370 [0.239, 0.500] |
| بازیابی MRR@10 | 0.941 | 0.487 |
| F1 پاسخ («نمیدانم» = ۰) | 0.276 | 0.016 |
| دقت ارجاع | 0.842 | 0.800 |
| وفاداری (ابتکاری) | 1.000 | 1.000 |
| F1 «نمیدانم» | 0.714 | 0.178 |
| نرخ پاسخ به پرسشهای پاسخدار | 0.966 | 0.217 |